Se ChatGPT, Claude o Perplexity non leggono il testo che il tuo sito genera con JavaScript, SEO Radar Italia te lo mostra già oggi. La card DOM Rendering confronta l’HTML grezzo inviato dal server con la pagina renderizzata. Guarda numero di parole, peso del documento, nodi DOM, title, meta e canonical, e segna come “DIVERSO” ogni differenza. Il test “Le AI vedono la tua pagina?” richiede la pagina con gli user agent di GPTBot, OAI-SearchBot, ClaudeBot e PerplexityBot e la confronta con quella vista da un browser.
Un esempio: un negozio online di Verona rifà il sito con un framework JavaScript e nel browser funziona tutto. Poi il titolare chiede a ChatGPT di riassumere la scheda del prodotto più venduto e riceve una risposta vaga. Il motivo è che quel testo non c’è nell’HTML iniziale.
Il 19 ottobre 2026 è uscito un nuovo test su questo problema, 434 giorni dopo una prima prova dell’agosto 2025. La domanda era la stessa: le piattaforme di ricerca AI riescono oggi a leggere i contenuti generati con JavaScript? Per le tre più usate fuori dai servizi di Google e Microsoft, nelle prove descritte, la risposta è ancora no.
Qui sotto trovi che cosa è stato provato, che cosa dicono i risultati e che cosa non dicono. Un test su tre pagine non basta a descrivere il comportamento di ogni crawler. Alla fine trovi come controllare il tuo sito.
Il test: come è stato fatto
Il metodo è semplice di proposito. Cinque piattaforme (ChatGPT, Claude, Perplexity, Gemini e Copilot) dovevano leggere una pagina e riportarne il primo e l’ultimo paragrafo. Le pagine usavano JavaScript in misura diversa. In alcune gli script generavano tutto il contenuto. In altre intestazione e piè di pagina erano nell’HTML statico, mentre il corpo principale arrivava solo dopo il rendering.
Il resoconto completo riporta tre casi.
| Pagina | ChatGPT | Claude | Perplexity | Gemini | Copilot |
|---|---|---|---|---|---|
| 1. Contenuto principale interamente in JavaScript | Non letto | Non letto | Non letto | Letto | Letto |
| 2. Header e footer in HTML, corpo in JavaScript | Non letto | Non letto | Non letto | Letto | Letto |
| 3. Sito parallax con grafica WebGL | Solo messaggio di errore | Solo messaggio di errore | Solo messaggio di errore | Letto | Solo messaggio di errore |
Nei primi due casi ChatGPT, Claude e Perplexity hanno restituito la “cornice” della pagina: menu, piè di pagina, link social, testi legali, il banner dei cookie. Il contenuto vero no. Più di una volta gli assistenti stessi hanno spiegato il motivo. ChatGPT ha risposto che l’estrazione aveva restituito solo navigazione e footer. Ha aggiunto che il contenuto principale poteva essere generato in modo dinamico.
The page loads, but none of the page’s actual content came through. […] That strongly suggests the main body is rendered client-side with JavaScript, which a plain HTML fetch doesn’t run.
Risposta di Claude riportata nel test del 19 ottobre 2026
Il terzo caso è il più curioso. A ChatGPT, Claude, Perplexity e anche a Copilot il sito parallax mostrava solo il testo di riserva previsto quando la grafica non parte, cioè un messaggio del tipo “la pagina non è stata caricata”. Perplexity ha perfino presentato quel messaggio come primo paragrafo della pagina. Solo Gemini ha letto le sezioni di testo, e ha segnalato a parte il messaggio di errore nel codice.
Perché Gemini e Copilot vanno meglio
La spiegazione proposta è che Gemini e Copilot si appoggiano ai sistemi di ricerca di Google e di Bing, che sanno eseguire JavaScript nella maggior parte dei casi. Per Google questo è documentato. La guida JavaScript SEO di Search Central spiega che Google Search esegue JavaScript con una versione aggiornata di Chromium e lavora in tre fasi: scansione, rendering e indicizzazione. Ma il caso 3 dimostra che anche un sistema con rendering può fermarsi davanti a pagine molto pesanti dal punto di vista grafico.
Cosa il test non dimostra
È un test esplorativo, utile per capire dove guardare. Non è una misura del comportamento universale dei crawler AI, e conviene leggerlo con alcune cautele.
- Il campione è piccolo. Tre pagine descritte nel dettaglio, scelte proprio perché dipendono da JavaScript. Non sappiamo come si comportano le stesse piattaforme su migliaia di siti diversi.
- Le risposte dei chatbot non sono log del server. Quando un assistente dice “ho visto solo il footer”, descrive il proprio risultato e non mostra le richieste HTTP che ha fatto. Non sappiamo se ha scaricato la pagina in tempo reale, se ha usato una copia in cache o un indice di ricerca.
- Il test non separa rendering, cache, blocchi ed estrazione del testo. Un contenuto può mancare perché il bot non esegue il JavaScript. Può mancare anche perché un firewall risponde in modo diverso a un bot, perché il banner dei cookie copre la pagina o perché l’estrattore scarta certi blocchi.
- Chat e crawler non sono la stessa cosa. Quando un utente chiede a ChatGPT di aprire una pagina, di norma la richiesta parte da ChatGPT-User, un agente attivato dall’utente. La ricerca e l’addestramento usano invece OAI-SearchBot e GPTBot. La documentazione dei crawler OpenAI li descrive come agenti distinti, ma non dice se eseguono JavaScript.
Il risultato però non è isolato. Già a fine 2024 un’analisi del traffico dei crawler AI su una grande rete di siti aveva notato che i crawler di ChatGPT e Claude scaricavano i file JavaScript senza eseguirli. Quindi non leggevano i contenuti generati lato client. Due osservazioni a distanza di quasi due anni vanno nella stessa direzione. Anche Google, nella sua guida, ricorda che il rendering lato server o il pre-rendering restano una buona idea: rendono il sito più veloce e non tutti i bot sanno eseguire JavaScript.
Keep in mind that server-side or pre-rendering is still a great idea because it makes your website faster for users and crawlers, and not all bots can run JavaScript.
Google Search Central, Understand the JavaScript SEO basics
Che cosa significa per un sito italiano
La regola pratica è prudente. Se un testo esiste solo dopo l’esecuzione di uno script, parti dal presupposto che ChatGPT, Claude e Perplexity possano non vederlo. Non vuol dire che il JavaScript sia vietato. Vuol dire che il contenuto importante, quello che vuoi far citare, dovrebbe essere già nell’HTML che il server consegna.
Un e-commerce con schede generate lato client
Torniamo al negozio di Verona. Se descrizione, prezzo e recensioni arrivano da un’API dopo l’apertura della pagina, Google probabilmente li vedrà dopo il rendering. Un assistente AI che legge solo l’HTML iniziale troverà invece un guscio vuoto.
Il nostro consiglio è verificare che almeno nome del prodotto, descrizione principale, prezzo e dati strutturati siano presenti nell’HTML iniziale. Molti framework offrono il rendering lato server o la generazione statica delle pagine: è il modo più diretto per risolvere il problema senza rinunciare all’interfaccia.
Un sito vetrina “d’effetto”
Uno studio di architettura con un sito tutto animazioni e grafica 3D è il caso 3 del test. Bello da vedere, ma se il testo dipende dall’avvio della grafica, chi non la esegue legge solo il messaggio di riserva.
Il testo di riserva non dovrebbe essere un messaggio di errore. Dovrebbe essere una versione testuale dei contenuti: chi siete, cosa fate, dove siete, come contattarvi. Così anche chi non vede l’animazione legge qualcosa di utile.
Come controllarlo con SEO Radar Italia
Questa verifica è già nel nostro strumento. SEO Radar Italia analizza le pagine anche con un motore di rendering basato su Playwright, pensato per i siti costruiti in JavaScript (lo trovi nel changelog, versione 5.3.1). Nel report ci sono due controlli che riguardano direttamente il tema del test.
La card DOM Rendering (Raw vs JS)
La card DOM Rendering confronta l’HTML grezzo inviato dal server con il DOM ottenuto dopo l’esecuzione del JavaScript. Serve a capire se title, meta description, robots, canonical e dati strutturati sono già nel codice statico oppure compaiono solo dopo il rendering. Il risultato è un livello di confidenza (tecnicamente indicizzabile, a rischio, bloccata) con il dettaglio delle differenze per ogni segnale.
La stessa card confronta anche il volume del testo, cioè il numero di parole, e il peso del documento HTML con il numero di nodi DOM, nelle due versioni. Se i valori non coincidono, la riga viene segnata come “DIVERSO”. In un report reale abbiamo visto 1.192 parole nell’HTML grezzo, quello che legge un bot, contro 1.275 nella pagina renderizzata. Il documento passava da 136,1 KB con 675 nodi a 203,7 KB con 717 nodi dopo il JavaScript. Quindi circa 80 parole di quella pagina esistono solo dopo l’esecuzione degli script, e un assistente che non la esegue non le vede.
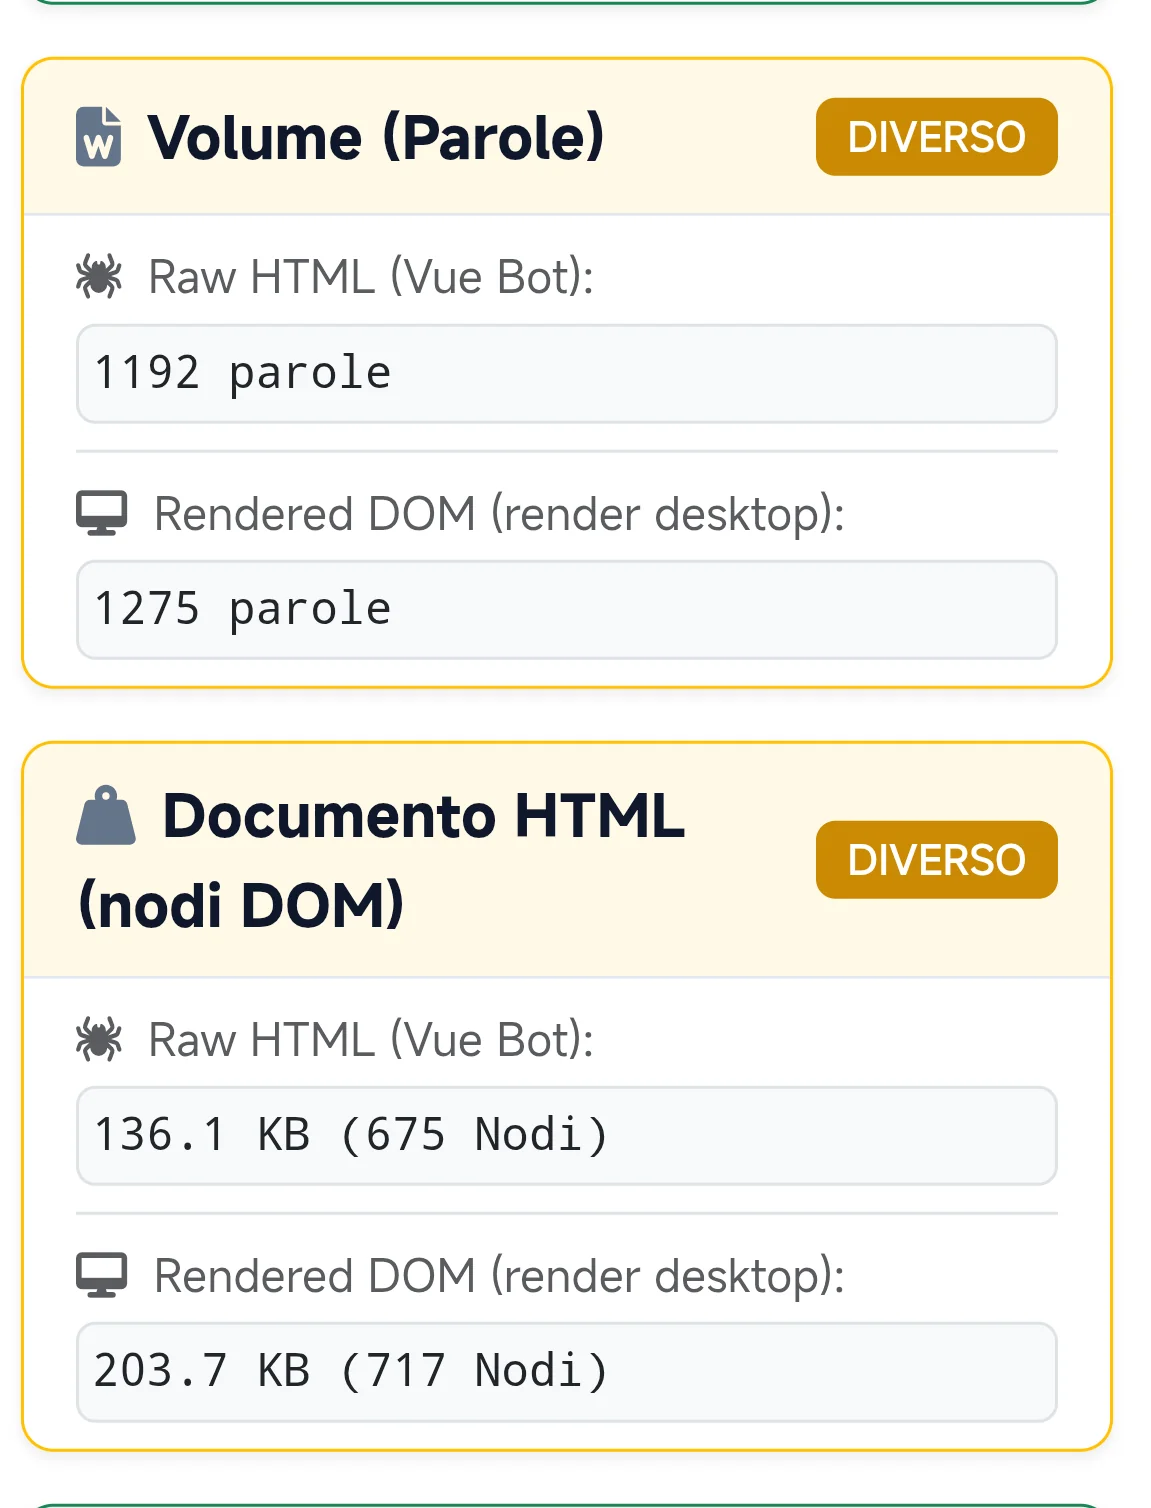
Gli assistenti AI del test inciampano proprio su questa differenza: leggono quello che c’è nell’HTML grezzo, spesso non quello che arriva dopo. Il conteggio delle parole dice quanta parte del contenuto manca senza JavaScript. Se la card mostra segnali presenti solo nella versione renderizzata, è un campanello d’allarme sia per la prima passata di Google sia per i bot che il JavaScript non lo eseguono.
Il test “Le AI vedono la tua pagina?”
Nella scheda Accesso della card GEO un controllo richiede la pagina con gli user agent dichiarati di GPTBot, OAI-SearchBot, ClaudeBot e PerplexityBot. Poi confronta le risposte con la versione per browser. La stessa scheda riporta l’esito del robots.txt per i diversi gruppi di crawler AI. Dall’ultimo aggiornamento (versione 6.2.1) il riepilogo distingue “Nessuna risposta” da “Contenuto diverso”, cioè il caso in cui il sito risponde al bot ma con qualcosa di diverso da ciò che vede un utente.
Anche questo controllo è diagnostico. Molti firewall verificano anche l’indirizzo IP del bot, quindi un bot vero può ricevere una risposta diversa da quella del nostro test. È lo stesso limite visto sopra: nessuno strumento esterno può riprodurre al cento per cento ciò che fa un crawler di terze parti. Può però mostrarti in pochi secondi dove la tua pagina rischia di apparire vuota.
Checklist rapida
- Apri la pagina con JavaScript disattivato nel browser: il testo principale c’è ancora?
- Controlla nel codice sorgente (non nell’ispezione elementi) se title, meta description, canonical e contenuto sono presenti.
- Lancia un’analisi su SEO Radar Italia e guarda la card DOM Rendering: le discrepanze tra Raw e JS indicano cosa spostare lato server.
- Guarda il test “Le AI vedono la tua pagina?” nella card GEO: un “Contenuto diverso” merita un controllo su firewall e CDN.
- Verifica nel robots.txt di non bloccare per errore i bot di ricerca AI che vuoi lasciare passare.
- Se usi animazioni o WebGL, prepara un testo di riserva con le informazioni essenziali, non un messaggio di errore.
- Ripeti il controllo dopo ogni rilascio importante del sito.
Fonti
- GSQi: 434 Days Later – Are AI Search Platforms Like ChatGPT and Claude Still Unable To Render JavaScript In October 2026? (19 ottobre 2026)
- Google Search Central: Understand the JavaScript SEO basics
- OpenAI: Overview of OpenAI Crawlers
- Vercel: The rise of the AI crawler
- SEO Radar Italia: guida alla card DOM Rendering (Raw vs JS)
- SEO Radar Italia: guida alla card GEO
- SEO Radar Italia: changelog